Aller au contenu principal
Notification
ITPro
  • Ressources IT
  • Newsletter
Se connecter
S’inscrire
  • Cloud & Infrastructure
  • Cybersécurité
  • Data & IA
  • Workplace et Endpoints
Se connecter
S’inscrire
  • Facebook
  • X
  • Linkedin
  • Instagram

Inscrivez-vous

Newsletter iTPro

  • Cloud & Infrastructure
  • Cybersécurité
  • Data & IA
  • Workplace et Endpoints
  • Cloud & Infrastructure
  • Cybersécurité
  • Data & IA
  • Workplace et Endpoints
  1. Accueil
  2. Enjeux IT
  3. Initiation à l’écosystème Hadoop

Sommaire

Tech stories

  • Tech Stories

    DEVOPS REX 2026 : deux jours pour confronter les pratiques DevOps aux réalités du terrain

  • Tech Stories

    Les erreurs de gestion qui font exploser le budget de renouvellement du parc IT

Big Data et analytics Enjeux IT

Initiation à l’écosystème Hadoop

Par

Juvénal Chokogoue
Date
15 février 2018
Temps de lecture
3 minutes

Les entreprises qui souhaitent exploiter leurs données utilisent, aujourd'hui, Hadoop d'une manière ou d'une autre. Cependant, la valorisation des données a entraîné un foisonnement de problématiques qui nécessitent des réponses technologiques aussi différentes les unes que les autres. Hadoop a beau être le socle technique du Big Data, il n’est pas capable à lui seul…

Sommaire

A chaque nouvelle problématique, les développeurs sont obligés de coder de nouveaux modules, ce qui en plus d’être frustrant à mettre en production, réduit la productivité des équipes de développement, qui passent désormais leur temps plus au débogage du code qu’au développement.

C’est pour combler ces lacunes qu’un ensemble de technologies regroupées sous le nom d’écosystème Hadoop a été développé. L’écosystème Hadoop fournit une collection d’outils et technologies spécialement conçus pour faciliter le développement, le déploiement et le support des solutions Big Data. L’objectif de cet article est double :

  • passer en revue la fonction de chacun de ces outils de l’écosystème.
  • annoncer la sortie prochaine (prévue pour Mars/Avril) de l’ouvrage intitulé « Maîtrisez l’utilisation de l’écosystème Hadoop : Initiation à l’écosystème Hadoop» Editions Eyrolles, qui les traite de façon exhaustive.

L’ouvrage a pour but d’aider tout professionnel à utiliser de façon professionnelle 18 technologies clé de l’écosystème Hadoop à savoir : Spark, Hive, Pig, Impala, ElasticSearch, HBase, Lucene, HAWQ,  MapReduce, Mahout, HAMA, TEZ, Phoenix, YARN, ZooKeeper, Storm, Oozie, et Sqoop.

En attendant la sortie officielle de l’ouvrage, vous pouvez vous procurer gratuitement un extrait portant sur ElasticSearch. Pour le recevoir directement dans votre boîte mail (30 pages), cliquez sur le lien

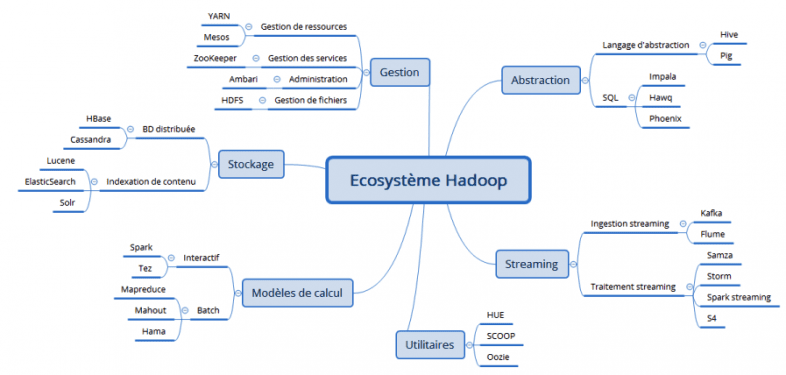
La carte heuristique suivante présente de façon globale l’écosystème Hadoop et résume particulièrement bien la structure de l’ouvrage.
 

Maintenant passons au vif du sujet

La configuration de base de l’écosystème Hadoop contient les technologies suivantes : Spark, Hive, PIG,  HBase, Sqoop, Storm, ZooKeeper et Oozie.

  • Spark

Avant d’expliquer ce que c’est que Spark, rappelons que pour qu’un algorithme puisse s’exécuter sur plusieurs nœuds d’un cluster Hadoop, il faut qu’il soit parallélisable. Ainsi, on dit d’un algorithme qu’il est « scalable » s’il est parallélisable (et peut donc profiter de la scalabilité d’un cluster). Hadoop est une implémentation du modèle de calcul MapReduce. Le problème avec le MapReduce est qu’il  est bâti sur un modèle de Graphe Acyclique Direct. En d’autres termes, l’enchaînement des opérations du MapReduce s’exécutent en trois phases séquentielles directes et sans détour (Map -> Shuffle -> Reduce), aucune  phase n’est itérative (ou cyclique).

Le modèle acyclique direct n’est pas adapté à certaines applications, notamment celles qui réutilisent les données à travers de multiples opérations, telles que la plupart des algorithmes d’apprentissage statistique, itératifs pour la plupart, et les requêtes interactives d’analyse de données. Spark est une réponse à ces limites, c’est un moteur de calcul qui effectue des traitements distribués en mémoire sur un cluster.

Autrement dit, c’est un moteur de calcul in-memory distribué. Comparativement au MapReduce qui fonctionne en mode batch, le modèle de calcul de Spark fonctionne en mode interactif, c’est à dire, monte les données en mémoire avant de les  traiter et est  de ce fait très adapté au  traitement de Machine Learning.

  • Hive

Hive est une infrastructure informatique similaire au Data Warehouse  qui fournit des services de requêtes et d’agrégation de très gros volumes de données stockées sur un système de fichier distribué de type HDFS. Hive fournit un langage de requête basé sur le SQL (norme ANSI-92) appelé HiveQL (Hive Query Language), qui est utilisé pour adresser des requêtes aux données stockées sur le HDFS.

Le HiveQL permet également aux utilisateurs avancés/développeurs d’intégrer des fonctions Map et Reduce directement  à leurs requêtes pour couvrir une plus large palette de problèmes de gestion de données. Lorsque vous écrivez une requête en HiveQL, cette requête est transformée en job MapReduce et soumis au JobTracker pour exécution par Hive. Voici un exemple de requête écrite en HiveQL. Trouver la température maximale par année.

USE default ;

CREATE TABLE records (year string, temperature INT, quality INT) ROW FORMAT DELIMITED FIELDS TERMINATED BY ‘\t’ ;

LOAD DATA LOCAL ‘data/sample.txt’ OVERWRITE INTO TABLE records ;

SELECT year, MAX(temperature) FROM records WHERE temperature !=9999 AND (quality == 0 OR quality == 1) GROUP BY year ;

Tech Stories

DEVOPS REX 2026 : deux jours pour confronter les pratiques DevOps aux réalités du terrain

Comment déployer une démarche DevOps efficace, sécuriser ses processus de développement et maîtriser les coûts de ses infrastructures ? Les 9 et 10 décembre 2026, DEVOPS REX réunit les professionnels…

Lire l'article : DEVOPS REX 2026 : deux jours pour confronter les pratiques DevOps aux réalités du terrain

Ressource IT

SIEM & PME : Comment construire la boîte noire de votre SI ?

Passez à la cybersécurité proactive, transformez la collecte et l’analyse des logs en un bouclier dynamique contre les cybermenaces. Découvrez comment mettre en place une approche SIEM modulaire, évolutive et…

Découvrir la ressource : SIEM & PME : Comment construire la boîte noire de votre SI ?

Inscrivez-vous

Newsletter iTPro

Juvénal Chokogoue

Rédigé par Juvénal Chokogoue

Consultant Insights & Data - Capgemini France

Tous ses articles →

Big Data et analytics

À lire également...

  • Analytique prédictive au service de la décarbonation en France sur iTPro.fr
    Big Data et analytics Enjeux IT

    L’analytique prédictive au service de la décarbonation en France

    Par

    iTPro
    Date
    26 mai 2026
    Temps de lecture
    5 minutes
  • Performance IA et Analytique et Fondations de données solides
    Big Data et analytics

    La performance de l’IA et l’analytique reposent sur des fondations de données solides

    Par

    IT Pro Magazine
    Date
    17 juillet 2025
    Temps de lecture
    5 minutes
  • l'IA dans l’analytique et la BI les défis et les bénéfices - iTPro - 2025
    Big Data et analytics

    Défis et bénéfices d’infuser l’IA dans l’analytique et la BI

    Par

    IT Pro Magazine
    Date
    27 janvier 2025
    Temps de lecture
    5 minutes
  • CLOUD INNOVATION PARTNERS VIA @ITPROFR
    Big Data et analytics Cloud & Infrastructure

    Cloud Innovation Partners décrypte les fuites de données

    Par

    Sabine Terrey
    Date
    27 octobre 2023
    Temps de lecture
    8 minutes
ITPro
  • X
  • Linkedin
  • Facebook
  • Instagram
Se connecter
S’inscrire
  • Cloud & Infrastructure
  • Cybersécurité
  • Data & IA
  • Workplace et Endpoints
  • Ressources IT
  • Espace responsable sécurité
  • Espace DSI
  • Espace Architecte IT
  • Espace IT Manager
  • Espace Responsable Data / IA

Inscrivez-vous

Newsletter iTPro

© iTPro.fr

  • Comité éditorial
  • Régie médias
  • Mentions-légales
  • Gestion et protection des données personnelles
  • Gestion des cookies
ITPro
Gérer le consentement aux cookies
Pour offrir les meilleures expériences, nous utilisons des technologies telles que les cookies pour stocker et/ou accéder aux informations des appareils. Le fait de consentir à ces technologies nous permettra de traiter des données telles que le comportement de navigation ou les ID uniques sur ce site. Le fait de ne pas consentir ou de retirer son consentement peut avoir un effet négatif sur certaines caractéristiques et fonctions.
Fonctionnel Toujours activé
Le stockage ou l’accès technique est strictement nécessaire dans la finalité d’intérêt légitime de permettre l’utilisation d’un service spécifique explicitement demandé par l’abonné ou l’internaute, ou dans le seul but d’effectuer la transmission d’une communication sur un réseau de communications électroniques.
Préférences
Le stockage ou l’accès technique est nécessaire dans la finalité d’intérêt légitime de stocker des préférences qui ne sont pas demandées par l’abonné ou la personne utilisant le service.
Statistiques
Le stockage ou l’accès technique qui est utilisé exclusivement à des fins statistiques. Le stockage ou l’accès technique qui est utilisé exclusivement dans des finalités statistiques anonymes. En l’absence d’une assignation à comparaître, d’une conformité volontaire de la part de votre fournisseur d’accès à internet ou d’enregistrements supplémentaires provenant d’une tierce partie, les informations stockées ou extraites à cette seule fin ne peuvent généralement pas être utilisées pour vous identifier.
Marketing
Le stockage ou l’accès technique est nécessaire pour créer des profils d’internautes afin d’envoyer des publicités, ou pour suivre l’internaute sur un site web ou sur plusieurs sites web ayant des finalités marketing similaires.
  • Gérer les options
  • Gérer les services
  • Gérer {vendor_count} fournisseurs
  • En savoir plus sur ces finalités
Voir les préférences
  • {title}
  • {title}
  • {title}