
En novembre 2025, à Orlando, lors de l’IBM TechXchange, un groupe s’est formé, composé de développeurs et de stratèges en IA venus du monde entier. Leur conversation revenait sans cesse à cette vérité tenace contre laquelle chacun se battait, quel que soit son secteur d’activité : les documents d’entreprise et les systèmes d’IA parlent des langues totalement différentes.
La raison cachée pour laquelle l’IA d’entreprise échoue : pourquoi DocLang est essentiel
Max Vermeir, VP AI Strategy, ABBYY partage son analyse et ses conseils sur le sujet.
Il y a trop de formats de fichiers, trop d’ambiguïtés, trop d’« hallucinations », parce que les formats disponibles n’ont tout simplement jamais été conçus pour être lus par l’IA : PDF, scans, JPEG, feuilles de calcul, e-mails et systèmes hérités. Cette prise de conscience a donné naissance à une collaboration qui a abouti à DocLang. Non pas en tant que produit, mais en tant que norme documentaire universelle. Un pilier sur lequel l’ensemble du secteur pourrait s’appuyer, au lieu que chacun réinvente sans cesse la même roue défectueuse.
Même ceux qui pensaient que le format des documents importait peu ont réalisé que les documents sont au cœur de chaque pipeline qui leur pose problème aujourd’hui. D’un côté, des décennies de connaissances métier enfermées dans des PDF, des formulaires numérisés et des feuilles de calcul. De l’autre, des grands modèles linguistiques (LLM) avides de données propres et structurées, qui s’étouffent avec le désordre que nous n’avons cessé de leur fournir. L’idée derrière DocLang est d’autant plus cruciale qu’elle met le doigt sur un problème que la plupart des dirigeants d’entreprise pressentent sans parvenir à le nommer : les formats de documents existants ne conviennent pas aux systèmes IA.
Pourquoi cette incompatibilité ?
« Nous disposons déjà d’une multitude de formats, en quoi la création d’un nouveau résoudrait-elle le problème ? » La réalité est que les formats auxquels nous faisons le plus confiance n’ont jamais été conçus pour permettre aux machines de les analyser, et chaque jour voit apparaître un nouvel outil ou une nouvelle fonctionnalité d’IA qui ne fait qu’aggraver ce problème.
Le PDF a été conçu pour l’impression, le HTML pour les navigateurs, et Markdown pour les rédacteurs qui souhaitaient mettre du texte en gras sans avoir à se soucier des balises. Les formats OCR, comme ALTO, capturent l’emplacement du texte sur une page, mais ne fournissent pratiquement aucune information sur la structure du document. Aucun n’a été conçu en pensant au raisonnement des machines, et encore moins aux capacités de l’IA générative et agentique que nous rencontrons aujourd’hui, et encore plus demain.
Lorsque vous soumettez un document à un processus d’extraction avec les formats traditionnels, trois éléments sont presque immédiatement altérés : l’ordre de lecture, les tableaux et le contexte sémantique. Lorsque l’ordre de lecture s’effondre, les mises en page à plusieurs colonnes s’entremêlent de manière incohérente, comme si l’on lisait un journal en sautant au hasard d’une colonne à l’autre. À mesure que les tableaux s’aplatissent, les relations entre lignes et colonnes qui donnent son sens à un chiffre se dissolvent en un mélange de texte décousu. Un chiffre dans un tableau financier n’a aucune signification sans l’en-tête au-dessus et la légende à côté.
Les signaux sémantiques s’évanouissent. Titres, légendes, listes et hiérarchies de sections : tous ces indices qui indiquent au lecteur où il se trouve disparaissent tout simplement. Cela signifie que l’IA n’a aucune idée du contexte qui lui a été fourni et qu’elle ne peut désormais plus expliquer ni justifier le résultat qu’elle élabore pour vous.
Des recherches sur la famille de modèles LayoutLM ont montré que l’entraînement conjoint sur le texte et sa mise en page bidimensionnelle donne systématiquement de meilleurs résultats pour les tâches de compréhension de documents. Si l’on fait abstraction de la mise en page, on prive les modèles modernes des caractéristiques dont ils dépendent. C’est là le cœur du problème.
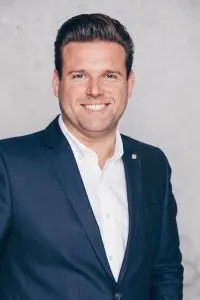
Max Vermeir, VP AI Strategy, ABBYY
Le coût réel du chaos documentaire
Lorsque des données erronées entrent dans un pipeline, les erreurs s’accumulent, et les coûts grimpent rapidement. Une étude comparant différentes tâches, domaines, techniques de modélisation et méthodes d’analyse a mis en évidence ce seuil critique : lorsque la précision de l’OCR tombe en dessous de 70 à 80 %, la plupart des tâches de traitement automatique en aval perdent en fiabilité. Les modèles entraînés sur des extractions bruitées n’apprennent pas le domaine de l’entreprise, ils apprennent le bruit. Il en résulte des taux d’hallucination plus élevés, une récupération moins performante dans les workflows RAG, et des pipelines qui nécessitent une surveillance constante.
À cela s’ajoute une charge cachée : l’analyse personnalisée. Chaque équipe développant une fonctionnalité d’IA impliquant des documents finit par réinventer la couche d’extraction. Les pipelines personnalisés se multiplient et tombent en panne dès qu’un document s’écarte de la mise en page attendue. Chaque nouveau type de document engendre un nouveau connecteur fragile. Multiplié à l’échelle de l’entreprise, cela donne une charge technique qui épuise discrètement les budgets et ralentit toutes les initiatives d’IA sur lesquelles l’organisation a misé son avenir.
Pourquoi une norme ouverte comme DocLang ?
Le principe directeur est simple : le PDF est destiné aux humains. DocLang est destiné à l’IA.
DocLang est un format de balisage contraint et natif pour l’IA qui offre aux systèmes une représentation sans ambiguïté du contenu des documents. Cela signifie que l’IA peut comprendre les éléments sémantiques, la provenance géométrique, la définition optimisée des tableaux et les métadonnées de gouvernance. Voilà à quoi cela ressemble :
- Éléments sémantiques
Les titres, paragraphes, légendes, notes de bas de page, tableaux, formules, codes, formulaires, listes et cases à cocher bénéficient chacun d’une représentation explicite. La structure est déclarée et l’IA n’a pas besoin de la deviner à partir d’indices visuels.
- Provenance géométrique
Les coordonnées du cadre de sélection ancrent chaque élément à sa position sur la page. Pour les factures, les contrats et les documents réglementaires, l’emplacement d’un champ par rapport à son libellé revêt une importance réelle.
- Définition optimisée des tableaux
Les tableaux sont les éléments les plus riches en informations et les plus souvent déformés dans les documents d’entreprise. Le langage « Optimized Table Structure Language » (détaillé par IBM) réduit le nombre de marqueurs structurels nécessaires pour représenter un tableau, de plus 28 en HTML à seulement cinq. Il divise par deux environ la longueur de la séquence, réduit de moitié le temps d’inférence et produit des structures de tableaux toujours correctes sur le plan syntaxique.
- Métadonnées de gouvernance
C’est l’aspect le plus important d’un point de vue stratégique. DocLang permet aux documents de contenir des règles lisibles par les machines concernant la présence d’informations à caractère personnel, les autorisations d’extraction, les contrôles RAG et de récupération, les restrictions d’entraînement, ainsi que des références explicites à des cadres réglementaires comme le RGPD, la norme ISO 27001 et la loi européenne sur l’IA. La politique accompagne les données, et n’est pas consignée dans un document séparé que personne ne lit.
La gouvernance a traditionnellement été cantonnée à des documents de politique générale, dont l’application reposait sur l’intervention humaine et la chance. DocLang rend la conformité exploitable par les machines. Un document qui ne peut pas être utilisé pour l’entraînement d’un modèle l’indique clairement et un système capable de lire DocLang peut respecter cette contrainte sans intervention humaine.
Pourquoi l’open source et l’indépendance vis-à-vis des éditeurs sont importantes
DocLang ne fonctionne que si personne n’en est propriétaire. C’est pourquoi il est hébergé par la Linux Foundation. La LF AI and Data Foundation a lancé le groupe de travail fondé par IBM, ABBYY et NVIDIA, sur la spécification DocLang selon un modèle de gouvernance ouvert et indépendant des éditeurs, et d’autres organisations rejoignent rapidement cette initiative.
DocLang vise à faire pour les documents ce que le HTML a fait pour le Web : créer un langage commun sur lequel tout le monde peut compter. Les normes ouvertes permettent également de briser la dépendance vis-à-vis d’un fournisseur. L’histoire le confirme avec, par exemple, Kubernetes pour l’infrastructure cloud native ou HTML pour le Web. Ces deux initiatives ont réussi parce qu’aucune entreprise ne détenait à elle seule les clés du système.
Mesures à prendre dès aujourd’hui
Voici des mesures déjà applicables en attendant une norme Doclang finalisée
- Audit des flux de traitement des documents
Recensement de tous les points d’entrée des documents dans un workflow d’IA. Calcul du nombre de parseurs personnalisés gérés et leur coût en heures d’ingénierie chaque trimestre.
- Mesure de la précision des extractions
À tester par rapport au seuil de 70 à 80 % de l’OCR. En dessous, les résultats IA reposent sur du sable, et aucune mise à niveau du modèle ne pourra les sauver.
- Évaluation de l’état de préparation de l’IA par type de document
Les tableaux, les formulaires et les mises en page à plusieurs colonnes sont les premiers à poser problème lors de l’extraction. C’est la priorité.
- Vérification de l’application de la gouvernance
Les systèmes sont-ils aujourd’hui capables de respecter automatiquement une règle « ne pas utiliser pour l’entraînement » ? Si la réponse implique un tableur et un peu de chance, il y a du pain sur la planche.
- Avantage aux normes ouvertes pour les achats
Lors de l’évaluation des fournisseurs, il faut vérifier si leurs résultats sont conformes à des formats ouverts et interopérables.
Un avenir ancré dans DocLang
L’avenir est celui où les documents cesseront d’être de simples fichiers passifs pour devenir des ressources de données structurées, consultables et gérables. Et où l’IA passera de conjectures probabilistes à des conclusions déterministes, car elle recevra systématiquement, par sa conception, des données d’entrée propres, respectant la mise en page et sémantiquement explicites. La conformité sera garantie dès le traitement des données, et non plus découverte lors d’un audit avec six mois de retard.
Cette base commune est l’avenir que poursuit le groupe de travail DocLang. Les informations contenues dans les documents ont toujours eu de la valeur mais les formats en constituaient le maillon faible. Une norme ouverte et native pour l’IA corrige enfin cette faille, et elle le fait de manière ouverte, afin que l’ensemble du secteur puisse s’appuyer dessus pour progresser ensemble.
Téléchargez cette ressource

Mac en entreprise : le levier d’un poste de travail moderne
Ce livre blanc répond aux 9 questions clés des entreprises sur l’intégration du Mac : sécurité, compatibilité, gestion, productivité, coûts, attractivité talents, RSE et IA, et l’accompagnement sur mesure proposé par inmac wstore.
Les articles les plus consultés
A travers cette chaîne
A travers ITPro
- 9 défis de transformation digitale !
- Stockage autonome, Evolutivité & Gestion intelligente, Pure Storage offre de nouvelles perspectives aux entreprises
- Intelligence Artificielle : DeepKube sécurise en profondeur les données des entreprises
- 10 grandes tendances Business Intelligence
- Databricks lève 1 milliard de dollars !
Les plus consultés sur iTPro.fr
- Les entreprises sont engagées dans une course contre la montre face à l’accélération des cyberattaques alimentées par l’IA
- Sécurité : une approche dans la durée avant tout
- Guide Ultime des Raccourcis Clavier Windows 11 pour les Professionnels IT
- RSSI 2026 : entre IA, réglementation et dépendances, l’art de l’arbitrage
Articles les + lus
Gestion et sécurité des e-mails : tout est-il vraiment sous contrôle ?
Data centers : 31 600 milliards de dollars d’investissements d’ici 2050, l’énergie au cœur de la nouvelle géographie du calcul
IA de confiance : le facteur clé pour rentabiliser les projets d’entreprise
Hôpitaux virtuels : renforcer le système de santé français grâce au numérique
Cybercriminalité bancaire : l’IA industrialise les attaques en 2026
À la une de la chaîne Data
- Gestion et sécurité des e-mails : tout est-il vraiment sous contrôle ?
- Data centers : 31 600 milliards de dollars d’investissements d’ici 2050, l’énergie au cœur de la nouvelle géographie du calcul
- IA de confiance : le facteur clé pour rentabiliser les projets d’entreprise
- Hôpitaux virtuels : renforcer le système de santé français grâce au numérique
- Cybercriminalité bancaire : l’IA industrialise les attaques en 2026




